01 核心思路
从动作块预测,到连续动作演化。
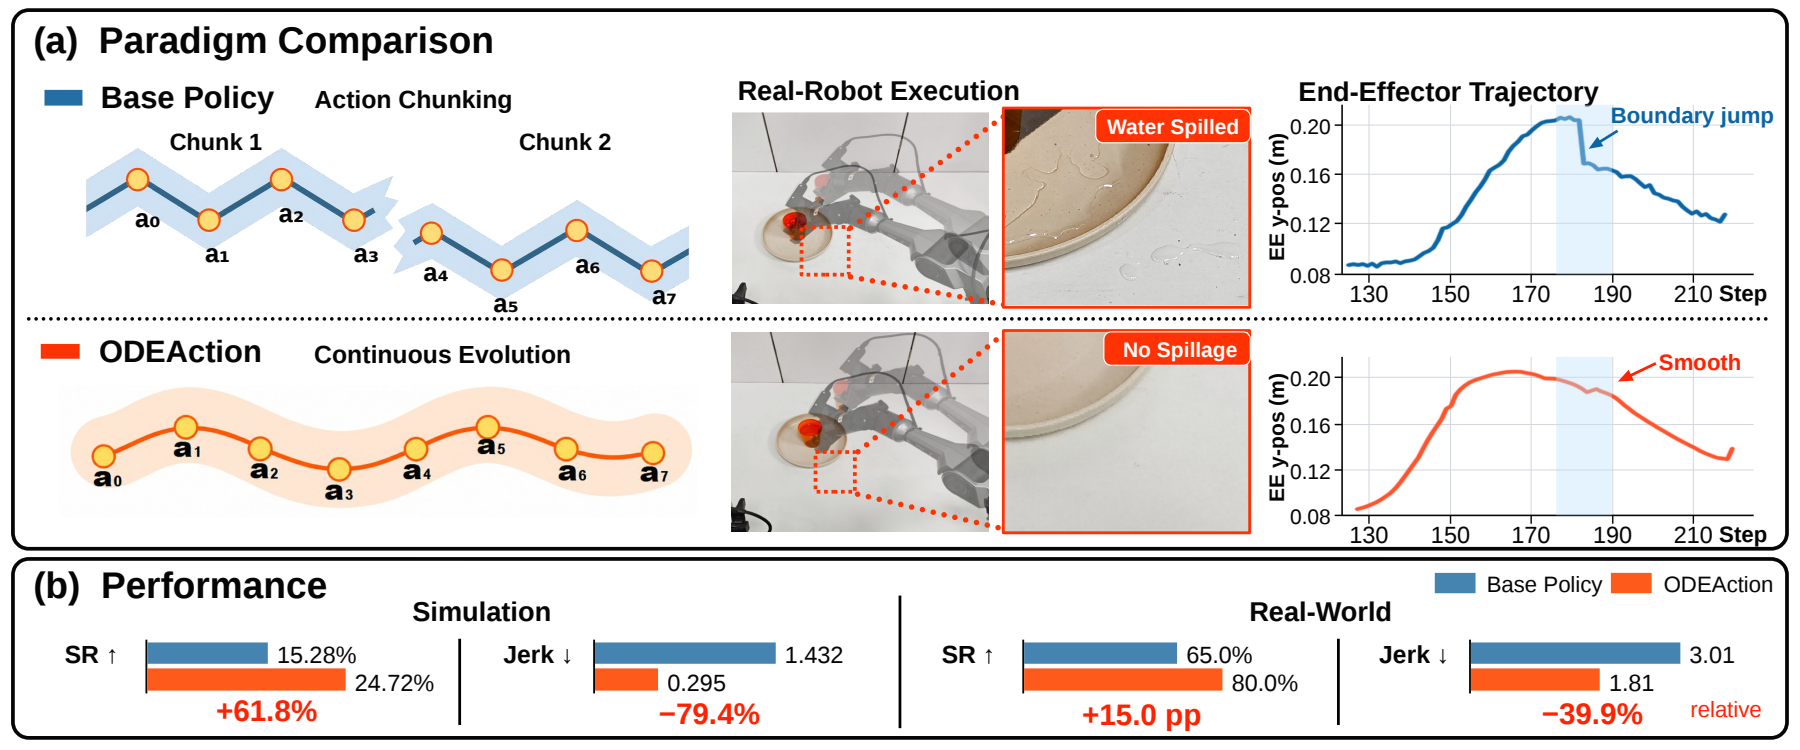
视觉语言动作模型通常将一段未来动作预测为一个动作块(action chunk)。机器人执行这些动作后,再切换到新预测的动作块。分别预测的动作块在切换时,可能在交界处产生突变。
ODEAction 改变了模型的预测对象:学习当前动作的演化率。从当前动作出发,对学到的演化率进行积分,递归生成后续动作,使每一步生成都与前一步建立明确的依赖。这就是从预测未来动作块,到连续动作演化(Continuous Action Evolution)的范式转变。
02 方法
学习动作转移场。
我们用常微分方程(ODE)描述动作的连续演化,并将其中的向量场定义为动作转移场(Action Transition Field)。给定查询动作、演化时间与任务条件,这个场给出动作的演化率。
图 2将三个步骤连接起来:从示范及其邻域构造目标场(a),通过直接监督学习条件场(b),再在推理时从当前动作出发,对学到的场进行积分(c)。通过这三个步骤,模型从示范动作中学会动作如何演化。
从示范中构造目标演化率。
首先,通过插值将离散示范动作连接成连续路径 γ(τ),路径的切向量描述示范动作的推进方向与速率。递归生成的动作可能偏离这条路径,因此我们进一步在路径附近采样,将监督扩展到邻域。
对于每个查询动作,推进分量描述对应演化时刻沿示范的变化,校正分量则指向对应的示范动作。二者相加得到目标演化率。下方动画自动展示查询位置沿路径及在路径两侧变化时,两个分量如何共同决定演化率;也可以切换到手动探索,自行选择查询位置。
一个动作,两个分量,一个演化方向
目标动作转移场 · F*
通过直接监督学习动作转移场。
目标场为每个采样动作及其演化时间提供目标演化率。模型结合当前观测与任务指令,学习预测这个向量。训练直接减小预测向量与目标向量之间的差异,无需通过 ODE 积分生成轨迹。
这对应图 2(b)中的场学习:示范与邻域查询动作共同提供监督,让模型学会路径上及路径附近的动作如何演化。
通过递归积分生成动作。
推理时,学到的场开始驱动动作生成。我们以当前动作为初始条件,每一步积分先查询动作转移场,得到演化率,再据此生成下一个动作。新动作成为下一步的起点,从而在整个生成序列中建立明确的递归依赖。
ODEAction 以模块化动作头的形式实现,可以将这一生成范式接入不同的视觉语言骨干。接下来的实验将考察,这种改变能否同时改善任务完成效果与运动质量。
动作的递归演化
aₙ₊₁ = aₙ + Δτ Fθ(aₙ, τₙ | c)学习到的动作转移场 · Fθ
03 实验表现
我们同时考察机器人完成了什么,以及它如何运动。成功率衡量任务完成情况,四项互补的轨迹指标则描述运动的平滑度与连续性。
首先在 LIBERO 和 EBench 上进行比较,再分析边界连续性与任务成功率的关系。随后,在 RoboTwin 上验证不同骨干下的适用性,与动作块续接方法比较,并评估真实机器人上的表现。最后,通过消融实验考察邻域监督与校正机制的作用。
与动作分块比较
以 π₀.₅ 为基线策略,我们在 LIBERO 和 EBench 上比较两种生成范式,将任务完成效果与所生成动作的平滑度、连续性放在一起考察。
边界连续性与任务成功率
上述提升引出了进一步的问题:边界连续性的改善与任务成功率有什么联系?图 3将各评测单元的边界不连续性降幅与成功率增益对应起来。
我们发现了一个一致的规律:边界不连续性降低越多,任务成功率的增益通常也越大,二者呈强正相关。这将生成动作的改善与任务执行效果联系了起来。
生成范式的通用性
同一种生成范式能否适用于另一种视觉语言骨干?我们将 ODEAction 接入 StarVLA-OFT,并在 RoboTwin 上进行评测。模块化动作头将连续动作演化扩展到了不同骨干与双臂操作场景。
与动作块续接方法比较
接下来,我们与在动作块生成框架内改善连续性的方法进行比较,考察学习动作演化与改善动作块之间的续接这两种思路,在任务完成效果和运动质量上的表现。
ODEAction 取得了最高的平均成功率,并在全部四项轨迹质量指标上获得最优结果,同时改善任务完成效果与运动质量。
真实机器人实验
这些提升也延续到了真实机器人上。我们在 AgileX Cobot Magic 平台上评估抓取放置、打开抽屉、端水杯和插入勺子等任务。
平均成功率从 65% 提升到 80%,四项轨迹质量指标也均得到改善。下方的任务图片与实验结果共同呈现了连续动作演化在实际执行中的表现。
消融实验
我们通过消融实验考察邻域监督与校正机制的有效性。缺少邻域监督时,动作生成的鲁棒性降低,动作可能离开已学习到演化方向的区域;缺少校正时,演化能够继续,但偏差无法得到纠正。
无邻域监督
监督仅覆盖示范路径。
有邻域,无校正
动作继续推进,偏移持续存在。
ODEAction
推进与校正共同引导动作回归。
邻域监督与校正共同支持稳健的动作演化,完整 ODEAction 也在消融实验中取得了最高的任务成功率。
表 4 · 消融实验